Uma pasta de projeto pode funcionar por semanas sem nenhum histórico. O problema aparece quando alguém altera três arquivos, quebra uma função e precisa descobrir qual era o estado anterior. O primeiro repositório Git cria esse ponto de retorno no próprio computador.
Este guia acompanha o caminho recomendado pelo Pro Git: iniciar uma pasta existente, conferir o estado, selecionar arquivos, registrar o primeiro commit e só depois pensar no repositório remoto.
Antes do primeiro comando
Escolha a pasta certa e abra o terminal nela. O comando pwd ajuda a conferir o caminho no macOS e no Linux; no Windows, o Terminal mostra a pasta atual no prompt. Essa conferência parece pequena, mas evita criar um repositório dentro de outra pasta por engano.
Também vale criar um arquivo .gitignore antes de adicionar tudo. Dependências, logs, arquivos de ambiente, builds e credenciais não pertencem ao histórico. Um token que entrou em um commit continua registrado mesmo depois de ser apagado da pasta.
O fluxo local em cinco movimentos
Rode git init para transformar a pasta em repositório. Depois, use git status para ver os arquivos que o Git ainda não acompanha. Escolha um arquivo pequeno, como README.md, e execute git add README.md.
O arquivo agora está na área de preparação. Ela funciona como uma seleção para o próximo registro. Se você adicionou algo por engano, use git restore --staged nome-do-arquivo. O arquivo não some; apenas sai do próximo commit.
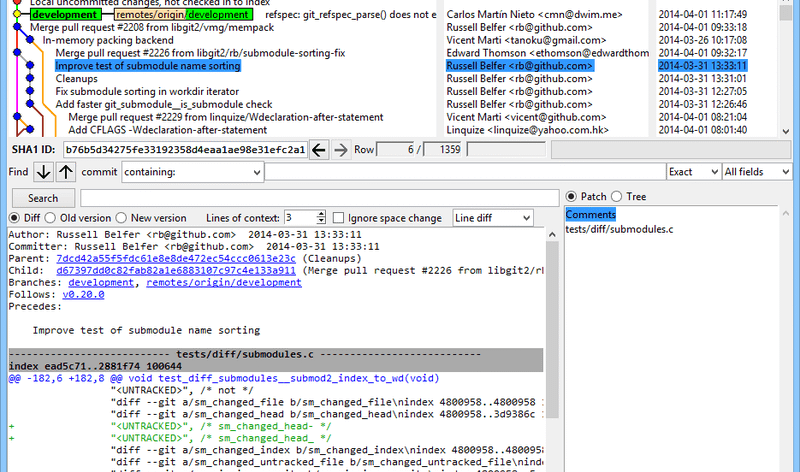
Quando a seleção estiver correta, rode git commit -m "Cria o primeiro registro do projeto". O commit fica local. Para consultar o histórico, use git log --oneline. Para enxergar uma alteração ainda não preparada, use git diff.
O outro começo possível é git clone URL. Ele serve para copiar um repositório que já existe e traz seu histórico. Não use git init dentro de uma pasta clonada: em geral, isso cria uma estrutura aninhada que só atrapalha.
O que fica para depois
GitHub, GitLab e serviços parecidos entram quando o histórico local já está funcionando. Um remoto acrescenta colaboração e backup, mas também exige autenticação e permissões. Primeiro confirme que o ciclo local está claro. Depois, conecte o endereço com git remote add origin URL e envie o histórico com git push.
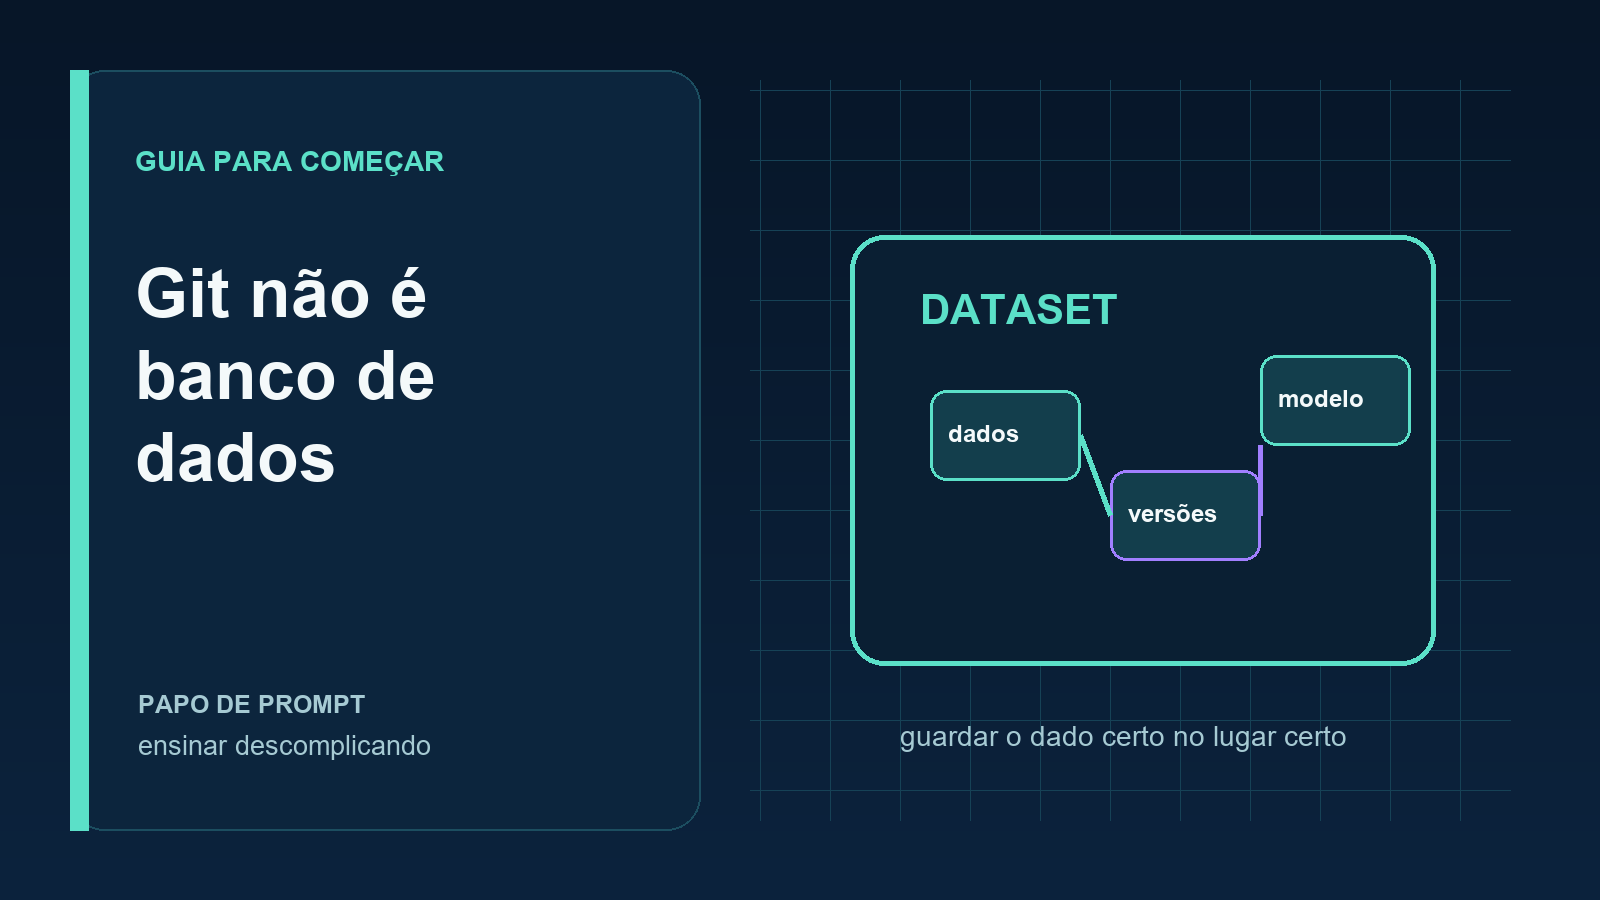
Git costuma ser o primeiro lugar onde um projeto de inteligência artificial guarda tudo. Código, configuração, uma planilha de exemplos e, quando alguém percebe, vários gigabytes de imagens ou textos. O problema não aparece no primeiro commit. Ele aparece quando o dataset muda toda semana, precisa de versões e começa a deixar cada operação lenta e cara.
O guia publicado no Hugging Face Blog parte de uma distinção simples: código e dados obedecem a ritmos diferentes. Um arquivo de código geralmente é pequeno, pode ser comparado linha a linha e precisa acompanhar cada alteração feita pela equipe. Um dataset pode crescer muito, conter arquivos binários e exigir cópias completas ou quase completas a cada versão. Tratar os dois como se fossem a mesma coisa cria um repositório difícil de clonar e difícil de manter.
Por que o Git começa a sofrer com datasets
O Git guarda o histórico das mudanças. Isso é ótimo quando a mudança é uma linha de código ou um arquivo de configuração. Em imagens, áudios, vídeos e grandes arquivos tabulares, a comparação deixa de ser útil e o repositório passa a carregar versões antigas que quase ninguém consulta. Mesmo depois de apagar um arquivo da pasta atual, ele pode continuar ocupando espaço no histórico.
Há outro efeito prático: cada pessoa nova na equipe precisa baixar uma quantidade de dados que talvez nem use. O clone inicial demora mais, os pulls ficam pesados e os ambientes de CI gastam tempo e armazenamento. Para quem está estudando, esse atrito aparece antes mesmo do primeiro experimento. Para a equipe, ele vira uma cobrança recorrente de infraestrutura.
O Git LFS resolve parte do problema ao manter ponteiros no repositório e arquivos grandes fora dele. Ainda assim, ele não transforma o Git em um catálogo completo de datasets. É preciso pensar em permissões, custos, retenção, nomes de versões e no local onde os arquivos serão armazenados. Um ponteiro quebrado também pode interromper a reprodução de um treinamento.
Uma divisão mais saudável para o projeto
Uma estrutura pequena pode separar quatro coisas: código de preparação, metadados, dados brutos e versões prontas para treino. O código fica no Git. Os metadados registram a origem, o formato, a data de coleta, a licença e o hash do arquivo. Os dados grandes ficam em um armazenamento próprio, com controle de versão ou snapshots identificados.
O conjunto usado por um experimento precisa ser recuperável. Em vez de escrever apenas “treinamento de agosto”, registre um identificador, a versão do dataset e os filtros aplicados. O resultado pode ser um arquivo de manifesto no repositório, apontando para os objetos guardados fora dele. Assim, uma pessoa consegue entender qual código e quais dados formaram aquele resultado sem baixar tudo de uma vez.
Também vale separar dado bruto de dado tratado. O bruto deve permanecer preservado quando a licença permitir. O tratado pode ser recriado por um script versionado. Se uma regra de limpeza mudar, a equipe gera uma nova versão e mantém a anterior para comparação. Isso evita substituir silenciosamente o material usado em um modelo que já foi avaliado.
Como começar sem montar uma plataforma enorme
O primeiro passo é olhar o próximo dataset, não tentar reorganizar toda a empresa. Liste o tamanho dos arquivos, a frequência de alteração e quem precisa acessá-los. Se o conjunto ainda é pequeno e muda pouco, Git pode continuar adequado. Quando arquivos binários começam a dominar o repositório, migre o armazenamento e deixe no Git apenas o código e os manifestos.
Depois, crie uma convenção de nomes e um arquivo de descrição. Inclua a fonte, a licença, o período de coleta, o esquema das colunas, o hash e a versão. Não coloque tokens, senhas ou dados pessoais nesse manifesto. O objetivo é tornar o experimento repetível sem transformar o repositório em um depósito de cópias.
O guia do Hugging Face não oferece uma fórmula única, e esse é um ponto útil. Uma equipe pode usar Git LFS, armazenamento de objetos ou ferramentas próprias para datasets. A escolha depende do tamanho, do orçamento, da necessidade de trabalhar offline e das regras de acesso. O erro é deixar essa decisão para depois de o repositório já estar pesado.
Para revisar o projeto atual, procure arquivos grandes no histórico, confira se o dataset tem licença clara e tente reconstruir um experimento a partir do código e do manifesto. Se ninguém consegue dizer qual versão dos dados foi usada, o problema não é apenas de espaço: é de rastreabilidade. A separação entre código e dados resolve a parte mecânica, mas o registro das decisões é o que mantém o projeto compreensível.
Fonte: Hugging Face Blog, Stop Abusing Git.
O ponto principal é separar o histórico do projeto dos arquivos que apenas ocupam espaço. O Git registra mudanças; ele não substitui armazenamento de datasets, backups ou um serviço de colaboração. Começar pequeno deixa os próximos comandos muito menos confusos.
Fonte principal: https://git-scm.com/book/en/v2/Git-Basics-Getting-a-Git-Repository.